이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
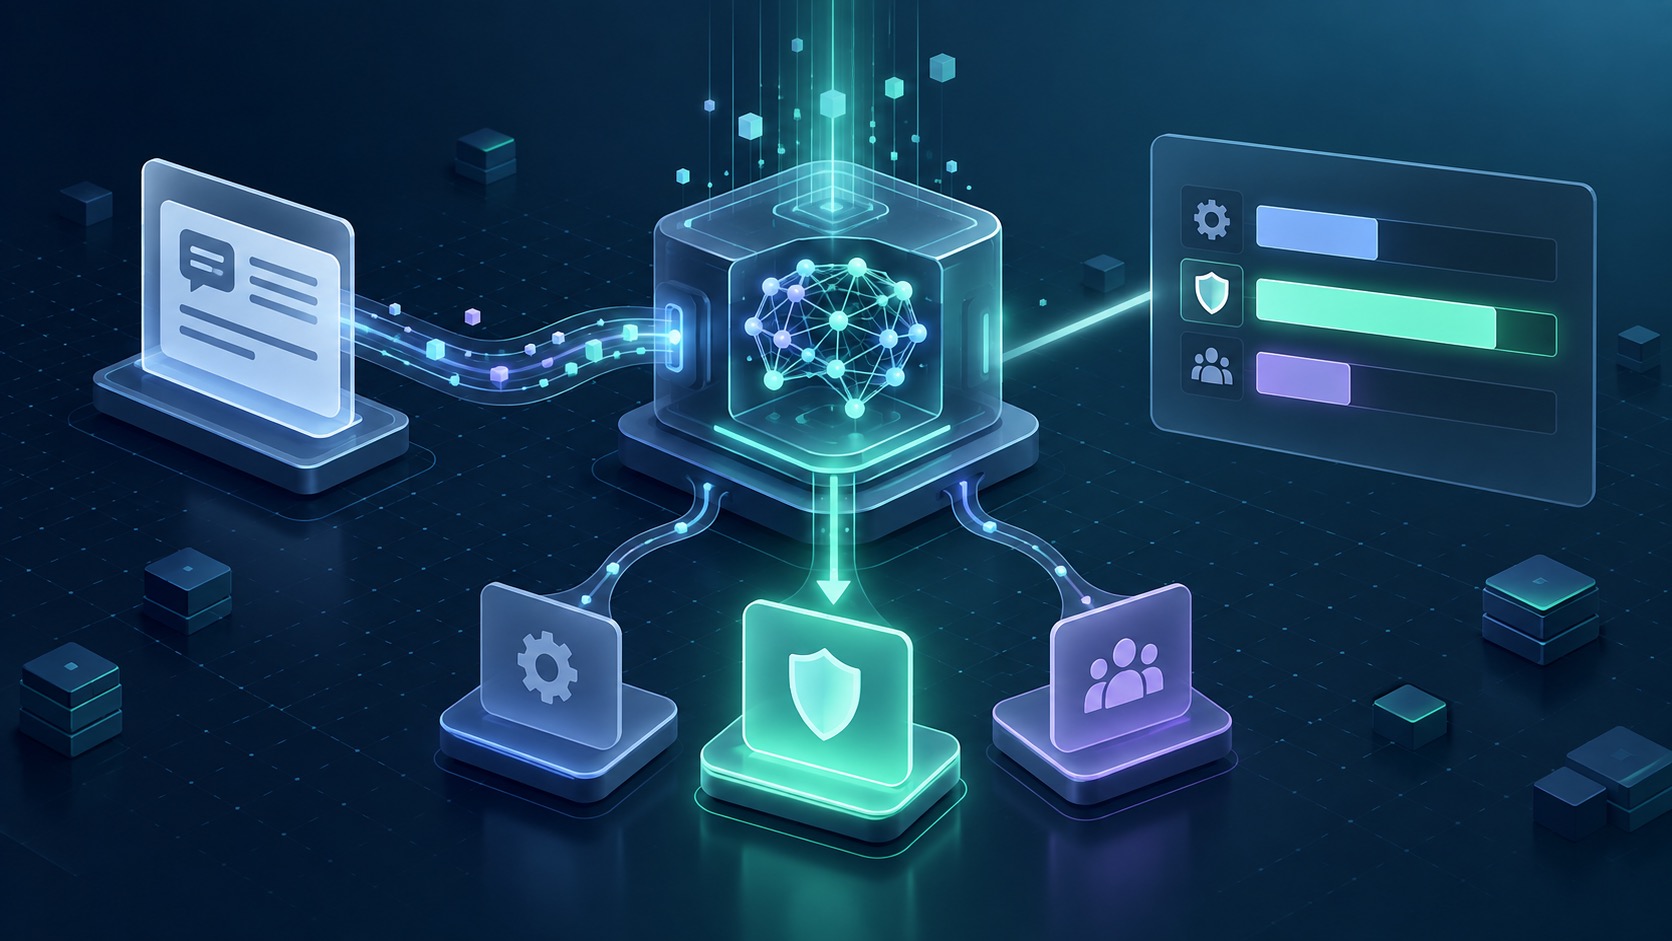
고객 문의를 자동으로 나눌 때가 있어요. “결제 문제인가?”, “지금 바로 봐야 하나?”처럼 답의 종류가 정해진 질문입니다. 이때 챗봇에게 JSON을 쓰게 한 뒤 다시 읽어 분기하는 흐름이 늘 깔끔한 것은 아닙니다. Jev AI는 이런 자리에 문장을 쓰는 대신, 정해 둔 선택지와 확률을 돌려주겠다고 나온 TypeSafe AI의 모델입니다.
공식 발표에서 TypeSafe AI는 Jev를 소프트웨어 안의 빠른 구조화 판단을 위한 첫 System One 모델이라고 소개합니다. 여기서 Semantic Decision은 “문장의 뜻을 읽고, 미리 정한 업무상 선택 가운데 무엇이 맞는지 고르는 일” 정도로 이해하면 편해요. 긴 답을 잘 쓰는 모델과 경쟁하기보다, 다음 코드가 바로 쓸 수 있는 판단값을 주는 쪽입니다.
Jev AI는 무엇을 돌려주는 모델인가
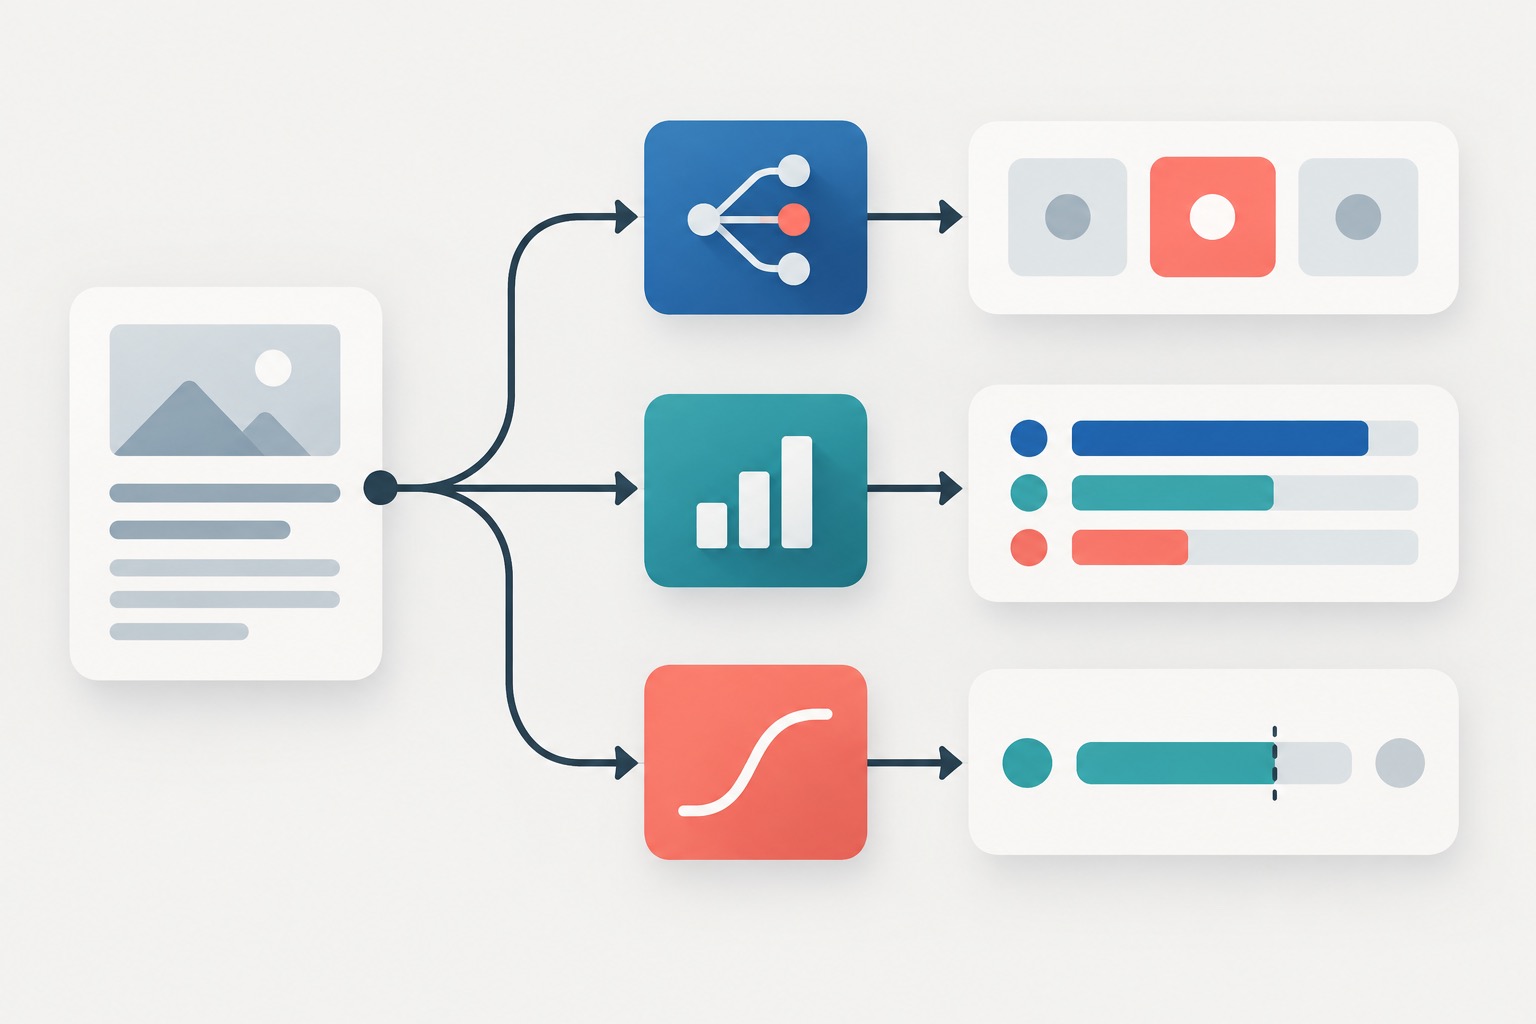
일반 LLM은 “어느 팀으로 보내야 하나요?”라는 질문을 받으면 설명 문장이나 JSON 문자열을 만들 수 있습니다. Jev는 그 대신 호출하는 쪽이 정한 타입의 답을 돌려줍니다. 공식 자료와 Cloudflare 모델 문서에 나온 질문 유형은 세 가지입니다.
| 질문 유형 | 쓰기 좋은 일 | 받는 값의 성격 |
|---|---|---|
| Choice | 담당 팀, 문의 분류처럼 하나를 고를 때 | 선택지별 확률과 선택 결과 |
| Score | 심각도처럼 순서가 있는 척도를 매길 때 | 척도 위 점수와 분포 |
| Noul | 긴급 여부처럼 예/아니오를 물을 때 | 두 경우의 확률 |
예를 들어 문의 본문은 state에 한 번 넣고, department와 is_urgent라는 질문을 함께 보낼 수 있습니다. department에는 billing, technical, sales처럼 허용할 값과 기준을 적습니다. 그러면 다음 단계의 프로그램은 문장을 해석하지 않고 선택 키를 보고 담당 큐를 고를 수 있어요. 이런 식의 요청과 응답 형태는 TypeSafe AI의 Jev 발표와 Cloudflare의 모델 문서에서 확인할 수 있습니다. 국내에서 읽기 쉬운 설명은 eigent의 소개 글과 digitalmarketer의 정리도 참고할 만합니다.
state: "카드 결제가 사흘째 실패하고 있습니다."

questions:
  department: Choice(billing, technical, sales)
  is_urgent: Noul(지금 대응이 필요한가)
위 코드는 API의 정확한 문법이 아니라 입력을 어떻게 나누는지 보여 주는 개념 예시입니다. 실제 필드명과 모델 버전은 배포 전에 제공사 문서로 다시 확인해야 합니다.
문장 생성과 Jev AI의 Semantic Decision은 어디가 다른가
차이는 답의 모양보다 다음 코드가 해야 할 일에서 더 잘 보입니다. LLM이 { "department": "billing" } 같은 문자열을 잘 만들면 편하지만, 호출하는 쪽은 형식이 맞는지 확인하고 실패한 응답을 다뤄야 합니다. Jev의 방향은 애초에 선택지 밖의 문자열을 받지 않게 만드는 것입니다.
그래서 Jev는 메일 분류, 정책 통과 여부, 검토 순서, 에이전트 라우팅처럼 “선택지는 이미 정했지만 입력 표현은 제각각인” 작업에 어울립니다. 반대로 고객에게 사과문을 쓰거나, 버그 원인을 설명하거나, 코드를 만드는 일은 선택만으로 끝나지 않습니다. 그때는 생성형 LLM이 맡아야 합니다.
일반 LLM도 구조화 출력을 지원할 수 있으니, JSON을 쓴다는 사실만으로 Jev가 꼭 필요해지는 것은 아닙니다. Apollo89의 AI Agent 글처럼 에이전트 흐름에서는 도구 실행 전의 분기가 특히 중요합니다. 이 분기만 별도 판단 모델에 맡길지, 기존 모델의 구조화 출력으로 충분할지는 실제 오류와 지연을 보고 고르면 됩니다.
모델 구조는 어디까지 알 수 있나
공개적으로 확인되는 것은 state와 타입이 있는 questions를 보내고, 여러 판단 결과를 받는 API 동작입니다. TypeSafe AI는 새 모델 아키텍처, 병렬 샘플러, RLCD(Reinforcement Learning for Calibrated Decisions)라는 학습 방법을 언급하지만, 레이어 수나 백본 모델, 정확한 출력 헤드는 공개하지 않았습니다.
그래서 “Jev가 어떤 Transformer를 쓰고 어떤 캐시를 공유한다”는 식의 내부 설명은 사실로 쓰면 안 됩니다. GeekNews에 소개된 외부 관찰은 공통 상태를 한 번 처리하고 질문별 분기를 함께 계산하는 구조와 잘 맞는다고 봤습니다. 하지만 이는 응답 시간과 입력량을 보고 세운 가설입니다. TypeSafe AI가 그 구현을 채택했다는 출처는 확인되지 않았습니다. 출처 확인 필요.
다만 빠른 이유를 이해하는 데는 이 구분만 기억하면 됩니다. 긴 문장을 토큰 단위로 계속 이어 쓰는 작업이 아니라, 제한된 후보 중 판단 분포를 내는 작업에 맞춘 모델이라면 출력 생성과 문자열 파싱 부담을 줄일 여지가 있습니다. 이것은 공개된 제품 방향에서 읽을 수 있는 설명이고, 특정 내부 구조의 증명은 아닙니다.
확률과 confidence는 자동 실행 허가증이 아닙니다
Jev가 반환하는 확률은 유용하지만 “0.9면 90% 정답”이라고 바로 읽으면 위험합니다. 공식 발표는 보정된 확률을 목표로 한다고 설명합니다. 그래도 새 문의 유형, 한국어 표현, 바뀐 라벨 체계에서는 실제 정답률이 달라질 수 있어요. 형식이 안전하다는 것과 선택 내용이 맞다는 것은 다른 문제입니다.
자동화를 붙일 때는 아래처럼 행동을 나눠 두는 편이 낫습니다.
- 높은 확률: 자동 라우팅하되 결과를 기록합니다.
- 경계 구간: 사람 검토 큐로 보냅니다.
- 낮은 확률 또는 새 라벨: 자동 실행하지 않고 원문과 함께 확인합니다.
임계값은 제공사가 정해 줄 숫자가 아닙니다. 지난 문의처럼 정답을 아는 데이터로, 자동 처리율과 오분류 비용을 함께 보며 정해야 해요. 특히 선택지 순서나 비슷한 라벨을 추가했을 때 결과가 바뀌는지도 확인해 보세요. 외부 분석에서도 이런 민감도가 관찰됐지만, 제품 전체에 일반화할 수 있는 공식 결과는 아닙니다. 출처 확인 필요.
잘 맞는 곳부터 작게 붙여보면 됩니다
Jev는 “무슨 말을 할까?”보다 “어느 길로 보낼까?”가 중요한 곳에 맞습니다. 문의를 팀별로 나누기, 긴급 티켓을 먼저 보기, 사람이 검토할 항목을 추리기처럼 답의 경계가 비교적 분명한 작업이 좋은 시작점입니다.
반대로 답의 근거를 독자에게 설명해야 하거나, 새 선택지를 스스로 찾아야 하거나, 긴 글·코드·대화가 필요한 일에는 Jev만으로 부족합니다. 생성 모델이 초안을 만들고 Jev가 통과·분기 판단을 하는 식으로 나누면 역할이 더 또렷해져요.
Jev AI를 시험한다면 첫 목표를 “모든 판단 자동화”로 두지 말고, 사람이 하던 한 가지 분류를 안전하게 줄이는 데 두면 됩니다. 라벨 정의와 보류 경로를 먼저 만들고, 실제 데이터에서 확률이 얼마나 믿을 만한지 확인한 뒤 범위를 넓혀보세요.
참고: TypeSafe AI 공식 발표, Cloudflare Jev 모델 문서, Jev를 소개한 참고 글, Jev를 정리한 참고 글, GeekNews의 외부 아키텍처 분석 소개